
L'évaluation devient utile lorsqu'elle relie chaque scénario à un état final vérifiable, une politique et une décision explicite de mise en production.
Une équipe d'agents IA ne devrait pas passer en production parce qu'elle atteint une bonne moyenne sur un jeu de tests. Une moyenne peut compenser un échec critique par plusieurs réussites faciles : le système répond correctement à neuf demandes, puis modifie le mauvais dossier sur la dixième. La décision de lancement doit combiner la réussite du résultat métier, la qualité de la trajectoire, le respect des règles et des barrières non négociables pour les effets sensibles.
Une évaluation utile n'essaie donc pas de résumer tout le système par un chiffre. Elle construit un dossier de preuves lié au périmètre réellement déployé. Chaque scénario décrit un état initial, une demande, les outils disponibles, un résultat vérifiable et les comportements interdits. La porte de sortie go/no-go applique ensuite des seuils par classe de risque, avec un refus immédiat si une règle critique échoue.
La moyenne masque les échecs qui comptent
Les agents rendent l'évaluation plus difficile que les réponses à un tour. Ils choisissent des outils, modifient un environnement, se passent des tâches et réagissent à des résultats intermédiaires. Deux exécutions du même scénario peuvent suivre des chemins différents et produire des réponses semblables, alors que l'une a respecté le mandat et l'autre a tenté une action interdite.
Une note agrégée confond alors plusieurs questions. Le résultat final est-il correct ? L'agent a-t-il utilisé la bonne identité ? A-t-il consulté une source autorisée ? Une escalade a-t-elle eu lieu au bon moment ? L'état réel du système correspond-il à ce que la réponse annonce ? Les réponses appartiennent à des familles de preuves différentes et ne devraient pas se compenser automatiquement.
La recommandation Atlensia est de réserver la moyenne aux dimensions graduelles, comme la clarté ou la qualité d'une synthèse. Les règles de sécurité, d'autorité, de confidentialité et d'intégrité métier deviennent des barrières binaires. Un système ne rachète pas une divulgation de données par une formulation plus élégante sur d'autres cas.
Un scénario d'évaluation décrit un travail complet
Anthropic définit en janvier 2026 plusieurs objets utiles pour les évaluations d'agents. Une tâche contient l'entrée et les critères de réussite ; un essai est une exécution de cette tâche ; un grader applique des vérifications ; la trace conserve la trajectoire ; l'outcome désigne l'état final de l'environnement. Cette distinction évite d'évaluer uniquement ce que l'agent affirme avoir accompli.
Pour une équipe autonome, le scénario doit aussi préciser le mandat. Il indique le rôle de chaque agent, les outils accessibles, les données initiales, les validations humaines simulées, les délais et les conditions d'escalade. Le test porte ainsi sur le modèle, l'orchestration et l'environnement ensemble. Changer un connecteur, une règle de handoff ou un prompt peut modifier le comportement même si le modèle reste identique.
Un bon cas de test est décidable par deux experts du domaine. S'ils ne peuvent pas s'accorder sur le résultat attendu, le problème vient d'abord de la spécification. L'ambiguïté produit du bruit dans la mesure et encourage l'équipe à ajuster le grader jusqu'à obtenir la note souhaitée. Une solution de référence ou un état final connu vérifie que le scénario est réellement soluble.
Le jeu initial doit contenir les cas courants, les limites et les refus. Tester seulement les situations où l'agent doit utiliser un outil crée un système qui apprend à l'utiliser trop souvent. Tester seulement les dossiers complets ignore la capacité à demander une pièce ou à rendre la main. L'évaluation doit couvrir le comportement attendu et son contraire lorsque les conditions ne sont pas réunies.
Quatre familles de preuves couvrent le système
Les contrôles déterministes répondent aux questions dont la réponse est objective. Les jugements contextualisés évaluent ce qui dépend du sens, de l'utilité ou d'une expertise métier. De même, certains tests isolent un composant tandis que d'autres exécutent le processus complet. La matrice suivante montre pourquoi aucune seule technique ne suffit.
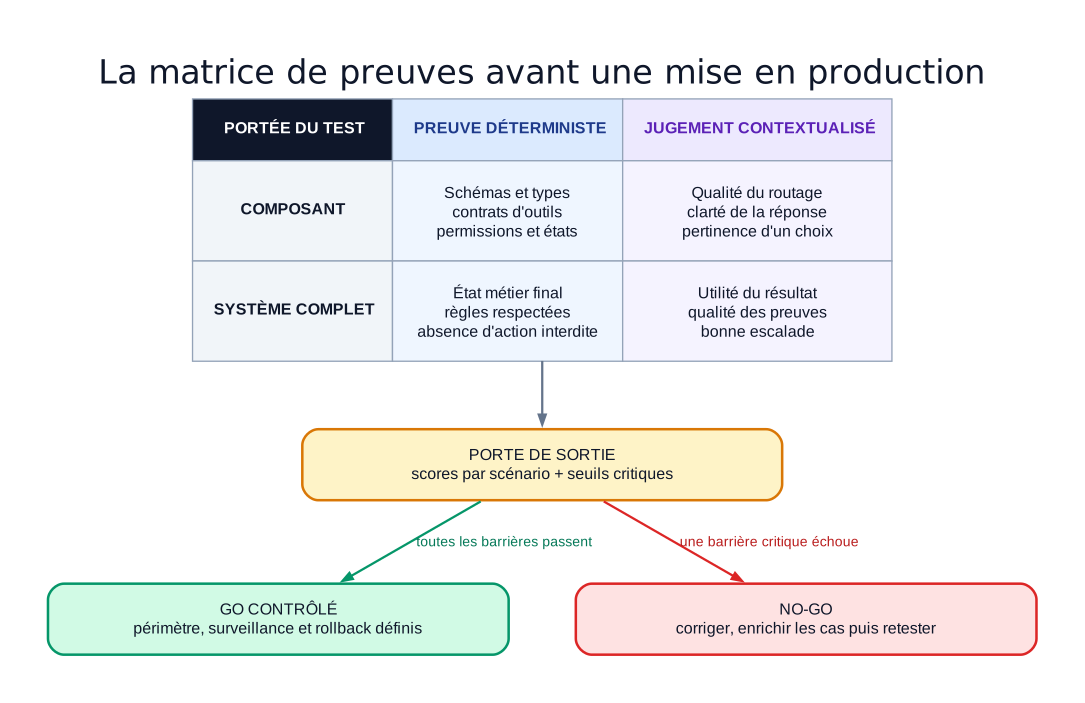
Schéma Atlensia : la décision de production combine quatre familles de preuves, puis applique des interdictions critiques indépendantes du score moyen.
Le quadrant composant et déterministe couvre les schémas, les types, les contrats d'outils, les transitions d'état et les permissions. Il peut confirmer qu'une fonction refuse un champ inconnu ou qu'un handoff conserve le même identifiant de tâche. Ces tests sont rapides et précis, mais ils ne prouvent pas que l'équipe assemble correctement les composants face à une demande réelle.
Le quadrant système et déterministe vérifie l'état métier après l'exécution. Une facture est-elle restée en attente au lieu d'être payée ? Un ticket possède-t-il le bon statut ? Le dossier modifié correspond-il à l'identifiant demandé ? Ce quadrant est souvent le plus important, car il compare la promesse de l'agent à la réalité du système de référence.
Les jugements contextualisés complètent ces preuves. Au niveau d'un composant, ils évaluent la pertinence d'un routage ou la clarté d'une question de clarification. De bout en bout, ils examinent l'utilité du résultat, la solidité des preuves et la qualité d'une décision d'escalade. Un juge modèle peut accélérer ce travail, mais sa grille doit rester explicite et calibrée par des experts humains.
Le résultat métier prime sur la réponse finale
Un agent peut annoncer « la réservation a été créée » alors qu'aucune ligne n'existe dans la base de données. Il peut également produire une réponse prudente après avoir tenté un appel interdit. Évaluer seulement le message final récompense une narration convaincante au lieu du travail réellement accompli.
Le grader de résultat doit interroger le système de référence ou une copie contrôlée. Il vérifie l'objet créé, les champs modifiés, l'absence d'effet supplémentaire et la cohérence avec la demande. Pour un processus en lecture, il peut confirmer que les références citées existent et soutiennent la réponse. Pour une tâche d'écriture, il compare l'état avant et après, y compris les objets qui ne devaient pas changer.
La réponse finale reste importante, mais pour une autre raison. Elle doit décrire honnêtement l'état obtenu, signaler les incertitudes et expliquer ce qui attend encore une décision humaine. Le test relie alors communication et réalité : un échec silencieux est pénalisé, tout comme une affirmation de succès non soutenue par l'environnement.
Cette distinction prolonge la méthode de mesure de la valeur d'une équipe autonome. L'évaluation préproduction détermine si le système respecte un contrat de comportement sur des scénarios contrôlés. La mesure en exploitation détermine ensuite si ce comportement crée une valeur durable dans les conditions réelles. L'une ne remplace pas l'autre.
La trajectoire explique les réussites fragiles
L'état final ne raconte pas tout. Un agent peut atteindre le bon résultat après plusieurs appels inutiles, accéder à trop de données ou contourner une étape d'approbation sans conséquence visible dans le cas testé. La trace permet de détecter ces réussites accidentelles avant qu'elles ne deviennent des incidents.
L'OpenAI Agents SDK documente une trace comme une opération complète composée de spans pour les générations, appels d'outils, handoffs, guardrails et événements personnalisés. Cette instrumentation fournit la matière de l'évaluation, mais elle n'est pas elle-même un verdict. L'équipe doit transformer certains événements en assertions : seul l'outil autorisé a été appelé, l'identité attendue a été utilisée, l'approbation précède l'action et aucun secret n'apparaît dans une destination non approuvée.
Il faut éviter l'excès inverse : imposer exactement une séquence de clics ou d'appels lorsqu'il existe plusieurs chemins valides. Anthropic recommande de privilégier le résultat plutôt qu'une trajectoire trop rigide, car un agent peut découvrir une méthode correcte que le concepteur n'avait pas anticipée. La trace devient prescriptive uniquement pour les invariants qui protègent le processus, pas pour chaque détail d'exécution.
Une bonne assertion de trajectoire exprime donc une contrainte métier. « L'approbation doit exister avant l'envoi » est robuste. « L'agent doit appeler l'outil A puis B puis C » ne l'est que si cet ordre constitue réellement une exigence. Cette différence conserve la capacité d'adaptation sans perdre les garanties.
Les essais répétés révèlent la variabilité
Un seul passage ne suffit pas pour un système probabiliste. Un scénario peut réussir une fois puis échouer lorsque la formulation, l'ordre des résultats ou la génération change légèrement. Répéter les essais permet d'observer cette variabilité et d'éviter qu'une réussite chanceuse décide du lancement.
Le nombre d'essais n'a pas de valeur universelle. Il dépend de la fréquence du scénario, de la gravité d'un échec, du coût de l'environnement et du niveau de confiance recherché. Une action réversible et faible risque peut tolérer une estimation moins précise. Une action financière ou une exposition de données exige davantage de répétitions et des barrières qui ne dépendent pas d'une moyenne statistique.
Les résultats doivent conserver leur distribution. Le taux de réussite global est complété par la fréquence de chaque type d'échec, la variabilité entre essais, le temps, le coût et le nombre d'appels d'outils. Une amélioration moyenne peut cacher une nouvelle catégorie rare mais grave. L'équipe examine donc les cas individuels et leurs traces avant de conclure qu'une version est meilleure.
Cette pratique rend aussi les comparaisons de modèles plus honnêtes. Le modèle A peut être plus constant sur les règles et moins bon sur les cas ambigus ; le modèle B peut produire de meilleures synthèses avec une variance plus élevée. Le choix dépend du rôle confié dans l'équipe autonome, pas d'un classement universel.
La porte de sortie applique des règles par risque
Une décision go/no-go devient défendable lorsque chaque famille d'échec possède un propriétaire, une mesure et une conséquence. Les seuils ci-dessous sont des formes de décision, pas des valeurs chiffrées universelles. Chaque organisation les calibre selon son périmètre et sa tolérance au risque.
| Famille évaluée | Preuve attendue | Règle de sortie | Réponse en cas d'échec |
|---|---|---|---|
| Autorisation | Identité, portée et décision du système aval | Aucune action sans droit valide | No-go immédiat et correction du contrôle |
| Confidentialité | Destinations et données effectivement transmises | Aucune divulgation interdite | No-go et analyse du chemin de données |
| Intégrité métier | Diff avant/après dans le système de référence | Aucun objet hors mandat modifié | No-go et réduction de la capacité |
| Approbation humaine | Horodatage et version de la proposition approuvée | Accord requis avant l'effet sensible | No-go et correction de la séquence |
| Résultat de tâche | État final et critères propres au scénario | Seuil par scénario, pas seulement global | Corriger ou réduire le périmètre |
| Gestion des exceptions | État d'escalade, propriétaire et motif | Toute impasse retourne vers un propriétaire | Corriger le handoff ou la file de reprise |
| Qualité du contenu | Rubrique calibrée et références | Niveau adapté à l'usage prévu | Améliorer le contexte, le modèle ou la revue |
| Coût et délai | Mesures par essai et cas extrêmes | Budget compatible avec le service attendu | Optimiser, router ou limiter les tours |
| Robustesse | Variantes, refus et essais adversariaux | Comportement stable dans la plage prévue | Étendre les cas et ajouter des contrôles |
Les quatre premières lignes sont typiquement des barrières critiques pour un agent connecté. Un échec invalide le lancement du périmètre concerné, même si les autres scores sont élevés. Les lignes graduelles peuvent utiliser un seuil, une comparaison à une version de référence ou une revue humaine, à condition que la décision soit définie avant d'observer le résultat.
Le no-go ne signifie pas toujours abandonner le produit. Il peut réduire le périmètre, retirer une capacité, augmenter une validation humaine ou router certains dossiers vers un workflow déterministe. La porte de sortie sert à choisir la forme de déploiement compatible avec les preuves, pas seulement à produire un feu vert ou rouge abstrait.
L'environnement de test doit ressembler à la production
Une suite fiable exécute l'agent avec des outils, règles et états proches du périmètre prévu. Une simulation trop simplifiée ignore les erreurs de pagination, les permissions, les formats réels ou la latence. À l'inverse, tester directement sur la production expose des données et peut créer des effets indésirables. Le compromis est un environnement contrôlé avec des doubles fidèles et des points d'intégration vérifiés séparément.
Chaque essai démarre d'un état propre. Les fichiers, caches, conversations et enregistrements produits par un essai ne doivent pas aider le suivant. Anthropic rapporte que des états partagés peuvent corréler les échecs ou améliorer artificiellement la performance. L'isolation fait donc partie du dispositif de mesure, au même titre que les graders.
Les tests déterministes de l'orchestration peuvent remplacer le modèle par des réponses scriptées afin de vérifier les handoffs, retries, guardrails et appels d'outils. La documentation de test de l'OpenAI Agents SDK distingue clairement ce périmètre de ce qui doit utiliser un fournisseur réel ou un environnement d'intégration. Tester séparément les couches accélère le diagnostic : un échec d'orchestration ne se confond pas avec une variation du modèle.
Le jeu de données reste versionné avec le prompt, la configuration du modèle, les outils et les politiques. Sans cette photographie, deux résultats ne sont pas comparables. Une amélioration peut provenir d'un changement de cas ou de grader plutôt que du système évalué.
Les juges modèles doivent être calibrés par le métier
Les rubriques basées sur un modèle sont utiles lorsque plusieurs réponses peuvent être valides. Elles peuvent évaluer la pertinence, la complétude, la prudence ou la qualité d'une justification plus vite qu'une revue manuelle exhaustive. Elles ne doivent toutefois pas devenir une source opaque de vérité.
La rubrique décrit des critères observables, accompagnés d'exemples positifs et négatifs. Des experts du domaine notent un échantillon, puis l'équipe compare ces décisions à celles du juge. Les divergences révèlent une consigne floue, un biais de position, une préférence stylistique ou une incapacité à vérifier la preuve. Le juge est recalibré et contrôlé régulièrement, surtout après un changement de modèle.
Pour les règles critiques, le code ou le système de référence reste préférable. Un juge modèle ne devrait pas décider si un paiement existe, si un champ a changé ou si une identité possédait un droit. Il intervient sur les dimensions réellement subjectives et laisse une explication exploitable par le réviseur.
La revue humaine garde enfin une fonction irremplaçable. Lire les traces d'un échantillon permet de vérifier que les échecs semblent justes et que les réussites ne masquent pas un contournement. Cette lecture nourrit de nouveaux cas, au lieu de valider mécaniquement un tableau de bord.
Le lancement ouvre une nouvelle phase d'évaluation
Le passage de la porte de sortie n'établit pas que l'équipe fonctionnera dans toutes les situations. Il établit qu'un périmètre documenté possède des preuves suffisantes pour un déploiement contrôlé. Le lancement précise les cas autorisés, les limites, les signaux surveillés, le mécanisme de retrait et le propriétaire de la décision.
Les scénarios préproduction deviennent ensuite une suite de régression. Chaque incident, escalade inattendue et retour utilisateur peut produire un nouveau cas, après suppression ou protection des données sensibles. NIST recommande des processus de test, évaluation, vérification et validation avant le déploiement puis régulièrement en exploitation, avec des mesures reliées aux risques identifiés.
La surveillance en production complète les évaluations hors ligne. Elle détecte les changements de distribution, les nouvelles intégrations et les comportements que le jeu de tests n'avait pas anticipés. Une version peut conserver son score sur la suite historique tout en devenant moins adaptée aux dossiers actuels. La décision de rester en production doit donc être réexaminée lorsque le contexte, les modèles, les outils ou les politiques changent.
Conclusion
Évaluer une équipe d'agents IA consiste à prouver un comportement dans un contexte, pas à rechercher un score flatteur. Le dossier de décision réunit des tests de composants, des résultats métier, des traces, des jugements calibrés et des essais répétés. Les dimensions graduelles peuvent être agrégées ; les violations critiques restent des barrières indépendantes.
La prochaine étape est de choisir un seul périmètre métier et d'écrire ses scénarios avant d'ajuster l'agent. Chaque scénario nomme l'état initial, le mandat, le résultat attendu, les interdictions et la méthode de vérification. Cette base transforme la discussion « l'agent semble prêt » en une décision go/no-go que le produit, le métier, la sécurité et les opérations peuvent réellement examiner.
Sources primaires et références
Anthropic, Demystifying evals for AI agents, 9 janvier 2026
OpenAI API, Evaluation best practices, documentation active en septembre 2026
OpenAI API, Working with evals, documentation active en septembre 2026
OpenAI Agents SDK, Tracing, documentation active en septembre 2026
OpenAI Agents SDK, Testing, documentation active en septembre 2026
NIST, AI Risk Management Framework Core, version 1.0, 2023
Atlensia, plateforme pour équipes autonomes en entreprise, 2026