
Choisir un mécanisme de déclenchement revient à définir un contrat de cohérence, pas seulement un objectif de latence.
Le bon mécanisme de déclenchement n'est pas nécessairement le plus rapide. Pour une équipe autonome connectée au CRM, à Microsoft 365 ou à un outil métier, la vraie question est de savoir si chaque travail pertinent sera détecté une fois, traité avec la bonne autorité et rapproché de l'état réel du système. Un webhook peut réduire le délai, mais il ne garantit ni l'exhaustivité ni l'autorisation d'agir.
Dans la plupart des opérations d'entreprise, la meilleure réponse est hybride. Le webhook ou le flux d'événements fournit un signal rapide, tandis qu'une interrogation périodique par état, curseur ou requête delta rattrape les interruptions et vérifie la cohérence. Le polling seul reste raisonnable lorsque la source ne publie pas d'événements fiables, que le volume est faible ou qu'un délai de quelques minutes est acceptable. Un bus d'événements devient pertinent lorsque plusieurs consommateurs, des pics importants ou un besoin de replay justifient son coût opérationnel.
Le choix du canal définit un contrat de cohérence
Présenter webhook, polling et flux comme trois variantes de transport conduit à choisir sur un seul critère, souvent la latence. Or le canal détermine aussi ce que l'équipe sait d'un changement, la manière dont elle prouve qu'il a été pris en charge et ce qui se passe après une coupure. Une notification peut arriver sans contenir l'objet complet, être livrée plusieurs fois, arriver après un événement plus récent ou ne jamais atteindre le consommateur.
Le contrat doit donc préciser l'unité de travail et non seulement le message reçu. Pour une demande commerciale, cette unité peut être la version d'une opportunité à qualifier. Pour une boîte partagée, elle peut être un message identifié avec son dossier, son expéditeur et son état courant. L'équipe autonome traite cette unité sous une identité et un mandat explicites, puis vérifie l'effet dans le système de référence.
Ce cadrage sépare trois engagements. La détection répond à « quelque chose a-t-il changé ? », la qualification répond à « ce changement mérite-t-il un travail ? », et l'exécution répond à « cette équipe est-elle autorisée à produire cet effet maintenant ? ». Confondre ces engagements transforme une simple notification en permission implicite.
Webhook, polling et flux ne résolvent pas le même problème
Un webhook est un appel HTTP initié par la source lorsqu'un événement survient. Le polling est une interrogation initiée par le consommateur, idéalement incrémentale avec un curseur ou une requête delta. Un flux d'événements intercale un journal ou un broker durable entre les producteurs et les consommateurs. Le tableau suivant compare les mécanismes selon les critères qui modifient réellement une décision d'architecture.
| Mécanisme | Atout principal | Limite structurante | Contrôle indispensable | Bon contexte de départ |
|---|---|---|---|---|
| Webhook direct | Faible latence et mise en oeuvre ciblée | Endpoint public, interruptions et redélivraisons | Signature, inbox durable et déduplication | Une source, un consommateur, volume modéré |
| Polling complet | Simplicité conceptuelle | Coût, quotas et fenêtres aveugles entre deux lectures | Horodatage de référence et pagination stable | Petit volume, API simple, délai tolérable |
| Polling delta | Reprise depuis un état connu | Dépend d'un curseur ou d'une sémantique fournisseur | Conservation du curseur et gestion de son expiration | Source offrant un journal de changements fiable |
| Flux ou broker | Absorption des pics, fan-out et replay | Plateforme, schémas et exploitation supplémentaires | Rétention, partitionnement, DLQ et observabilité | Plusieurs consommateurs ou forte variabilité |
| Hybride push plus delta | Rapidité et rattrapage | Deux chemins à tester et réconcilier | Identifiant commun et règle de convergence | Processus important exposé aux interruptions |
| Déclenchement planifié | Cadence prévisible et gouvernable | Réaction différée | Fenêtre métier, verrou et reprise après échec | Rapports, contrôles ou traitements par lots |
Cette grille ne désigne pas un gagnant universel. Elle montre surtout que le niveau de garantie recherché vient de la combinaison entre canal, stockage, reprise et logique métier. Un webhook sans journal peut être moins fiable qu'un polling delta bien conçu ; un bus d'événements sans consommateur idempotent ne protège pas contre les doubles effets.
Un webhook est une alerte, pas une file de travail
Les recommandations GitHub pour les webhooks illustrent bien cette séparation. GitHub conseille de limiter les événements souscrits, d'utiliser un secret, de vérifier HTTPS, de répondre dans le délai prévu, de retraiter les livraisons manquées et d'utiliser l'identifiant de livraison pour résister aux replays. Le endpoint doit reconnaître rapidement la notification, mais le travail long doit être confié à une file asynchrone.
Microsoft Graph impose le même principe avec des contraintes propres. Sa documentation active en septembre 2026 indique qu'une notification est considérée comme livrée lorsque le endpoint renvoie un code 2xx dans les trois secondes. Si le traitement ne peut pas finir dans cette fenêtre, Microsoft recommande de valider et persister la notification dans une file, puis de renvoyer 202 Accepted. La réponse HTTP signifie donc « signal reçu durablement », pas « dossier métier terminé ».
La frontière d'entrée devrait effectuer peu d'opérations : vérifier l'origine, valider un schéma minimal, attribuer un identifiant stable, persister le signal et répondre. Elle ne devrait pas appeler un modèle, charger plusieurs systèmes ni prendre une décision sensible avant l'accusé de réception. Ce découplage protège la livraison lorsque l'équipe autonome, un connecteur ou un modèle est ralenti.
Le payload n'est pas toujours la source de vérité. Après validation, le consommateur peut relire la ressource avec ses propres droits pour obtenir son état courant. Cette lecture limite la confiance accordée à des données poussées et permet d'appliquer les mêmes politiques que pour une requête normale.
Le polling devient une voie de reprise
Le polling est souvent rejeté comme une technique ancienne, alors qu'il reste un excellent mécanisme de contrôle. Une requête delta ou un curseur permet de demander « quels changements n'ai-je pas encore rapprochés ? » à partir d'un état connu. Ce chemin détecte les notifications manquées, les abonnements expirés et les effets qui n'ont pas convergé.
Microsoft Graph documente explicitement les événements de cycle de vie reauthorizationRequired, subscriptionRemoved et missed. Après une suppression d'abonnement ou une notification manquée, l'application doit recréer ou réparer l'abonnement, puis resynchroniser les données, par exemple avec une requête delta. La disponibilité d'un webhook ne supprime donc pas le besoin d'une stratégie de reprise.
Un polling robuste ne balaie pas nécessairement toutes les données. Il conserve un curseur, pagine de manière stable, limite le périmètre et enregistre l'instant jusqu'auquel l'état est confirmé. Si le fournisseur invalide le curseur, le système revient à une synchronisation contrôlée plutôt qu'à une reprise approximative.
Le coût doit cependant rester visible. Une fréquence trop élevée consomme des quotas sans améliorer la décision ; une fréquence trop basse allonge la période pendant laquelle un travail peut rester inconnu. Le bon intervalle dépend de la perte maximale acceptable, de l'urgence métier et de la capacité de la source, pas d'une cadence standard appliquée partout.
Un flux durable est justifié par le besoin de replay
Un broker ou un journal d'événements devient utile lorsque le signal doit survivre aux consommateurs, être distribué à plusieurs fonctions ou rejoué après une correction. Il absorbe les pics et découple le rythme des producteurs de celui des équipes autonomes. Cette capacité a toutefois un prix : exploitation de la plateforme, contrats de schéma, politiques de rétention, partitionnement, supervision et traitement des messages impossibles.
Google Cloud Pub/Sub rappelle que la livraison est généralement au moins une fois et que des messages peuvent être redélivrés ou arriver dans un ordre différent. Même une option « exactly once » possède un périmètre précis et ne supprime pas tous les doublons possibles à la publication. Le consommateur doit donc rester idempotent, c'est-à-dire produire le même état lorsqu'il reçoit plusieurs fois la même unité logique.
AWS EventBridge fournit un autre exemple de responsabilité explicite. Le service retente les livraisons selon une politique configurable et recommande une dead-letter queue pour conserver les événements qui épuisent les tentatives. Une DLQ n'est pourtant pas une solution automatique : elle a besoin d'un propriétaire, d'un délai de traitement et d'une procédure de replay vérifiée.
CloudEvents standardise des métadonnées communes pour décrire les événements indépendamment des plateformes. Cette enveloppe facilite le routage et la portabilité, mais elle ne définit pas à elle seule la sémantique métier. L'organisation doit encore expliquer ce que signifie customer.updated, quelle version fait foi, quelles données sont sensibles et quel effet est autorisé.
Le signal traverse une machine à états avant l'action
La machine à états ci-dessous rend visible la séparation entre transport et autorité. Webhook, flux et polling convergent vers la même inbox durable. Le signal est ensuite vérifié, qualifié, dédupliqué et rapproché d'une politique avant qu'une équipe autonome puisse agir.
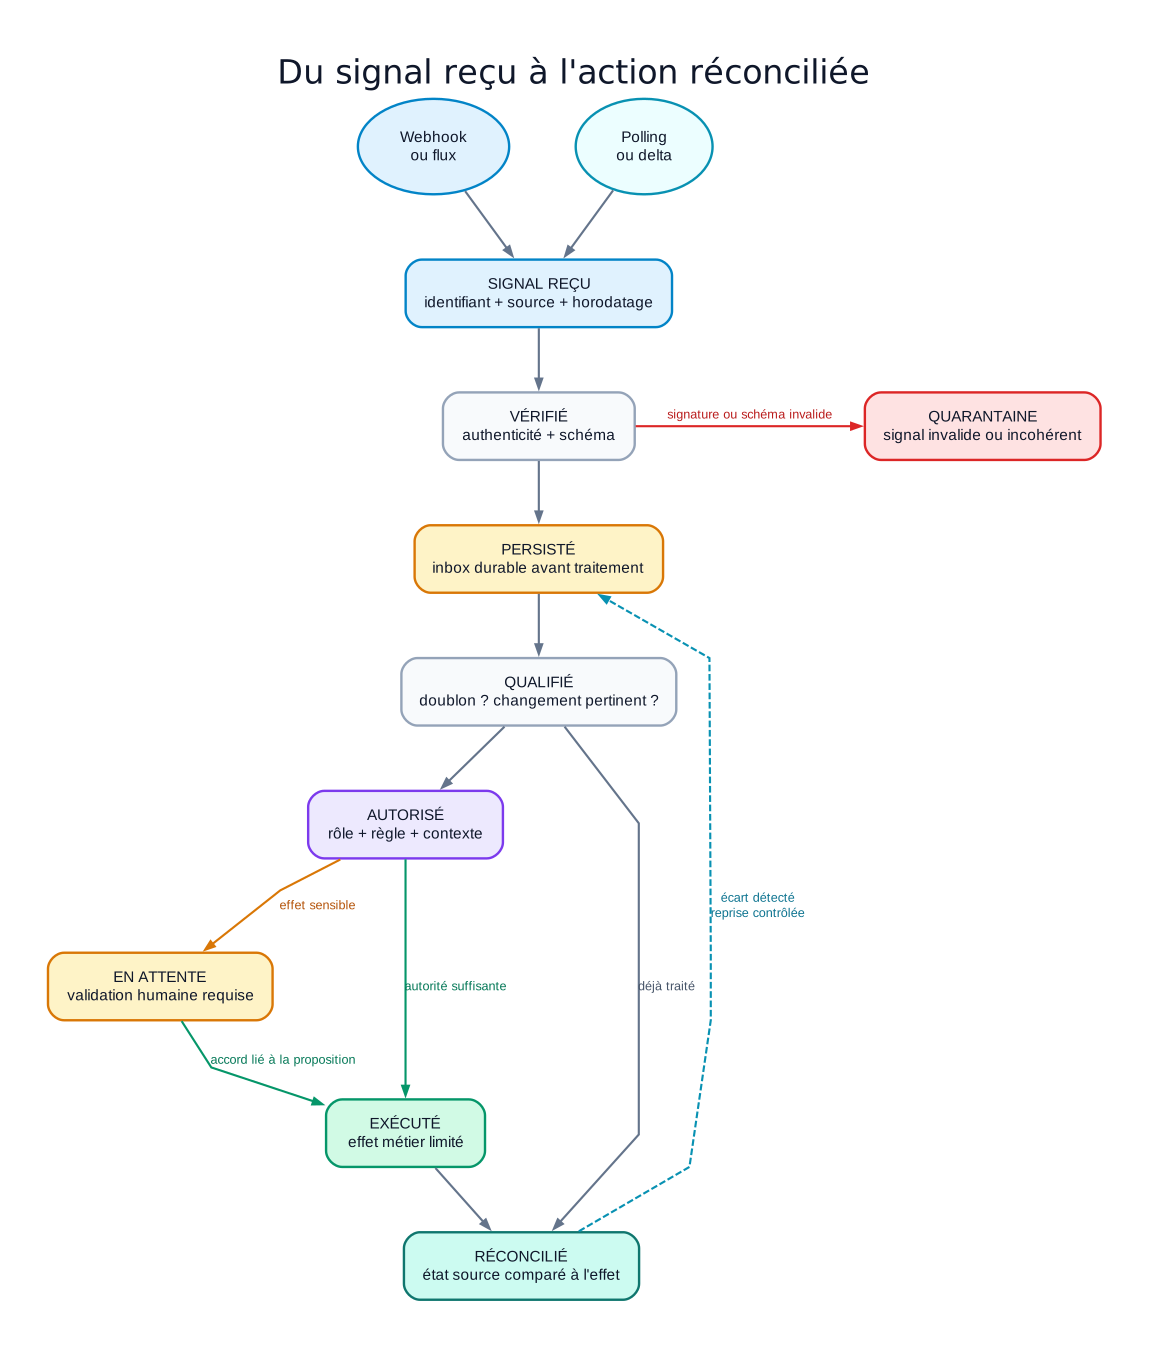
Schéma Atlensia : le canal détecte un changement, tandis que l'Operating Layer qualifie, autorise et réconcilie chaque action avant de clore le travail.
Le premier point important est la persistance avant traitement. Si l'accusé de réception est envoyé avant que le signal soit durable, une panne peut créer une perte silencieuse. Si l'accusé attend la fin du raisonnement, la source peut considérer la livraison comme échouée et multiplier les redélivraisons.
Le second point est la réconciliation après l'effet. L'équipe ne clôt pas une tâche parce qu'un outil a renvoyé une réponse favorable ; elle relit l'objet de référence ou vérifie un invariant métier. Un écart ramène l'unité de travail vers une reprise contrôlée au lieu de générer une seconde action aveugle.
Ce modèle complète la réflexion sur la connexion d'une équipe autonome par API, workflow ou MCP. Le protocole choisi pour appeler un outil ne décide pas de la manière dont le travail est détecté, persisté et repris. Les deux décisions doivent néanmoins partager les mêmes identifiants, politiques et traces.
Déduplication et ordre appartiennent au métier
Un identifiant de livraison permet de reconnaître un transport répété, mais il ne couvre pas toujours les doublons fonctionnels. Deux messages différents peuvent annoncer la même modification, et une nouvelle livraison peut porter un identifiant distinct après une republication. La clé idempotente doit donc représenter l'intention métier, par exemple l'objet, la version et le type d'effet attendu.
L'idempotence ne signifie pas ignorer toute répétition. Elle signifie que répéter le traitement ne produit pas un second paiement, une seconde notification ou une seconde modification incohérente. Le consommateur conserve le résultat associé à la clé, vérifie l'état courant et retourne une réponse cohérente sans répéter l'effet.
L'ordre demande la même prudence. Un événement « dossier fermé » peut arriver avant « dossier mis à jour » selon les partitions, retries ou réseaux. Plutôt que de supposer un ordre global, l'équipe compare une version, un numéro de séquence ou un horodatage émis par la source et refuse de faire régresser l'état.
Ces contrôles se testent par des scénarios de panne, pas seulement par le chemin nominal. Il faut interrompre le consommateur après la persistance, après l'appel outil et avant l'accusé final ; redélivrer le même signal ; inverser deux versions ; expirer un curseur ; puis vérifier que l'état métier converge sans double effet.
Détecter un travail n'accorde aucune permission
Une notification authentique prouve au mieux qu'une source connue a émis un signal. Elle ne prouve pas que le contenu est exact, que le dossier appartient au périmètre de l'équipe ou que l'action proposée respecte encore les règles. L'Operating Layer doit reconstruire le contexte d'autorisation au moment de l'exécution.
Ce contrôle associe l'identité de l'équipe, le rôle actif, la ressource, le type d'effet, la sensibilité des données et les validations requises. Une approbation humaine se lie à une proposition précise et à sa version ; si l'objet change après l'accord, la décision doit être réévaluée. Le webhook ne contourne jamais cette étape.
Dans Microsoft 365, cette séparation est particulièrement importante. Les notifications indiquent un changement, mais les accès utilisés pour relire ou modifier la ressource doivent rester limités. L'article Atlensia sur la connexion à Microsoft 365 sans élargir les risques décrit le cadrage des identités et permissions qui doit accompagner ce canal.
Mesurer la chaîne complète plutôt que le seul délai
Le temps entre l'événement source et la réception est une mesure utile, mais incomplète. Une équipe peut recevoir très vite et accumuler du travail dans une file, ou accuser réception sans produire l'effet attendu. La mesure doit suivre l'unité depuis la source jusqu'à la réconciliation.
Le tableau de bord opérationnel relie au minimum le retard de détection, l'âge du backlog, le taux de doublons, les échecs de validation, les retries, les éléments en quarantaine, les attentes humaines et les écarts de réconciliation. Il distingue aussi le délai du canal du délai de décision et du délai d'effet. Cette décomposition indique où intervenir réellement.
Les objectifs de service devraient porter sur une conséquence métier. « Toute demande prioritaire est détectée et assignée dans la fenêtre convenue » est plus utile que « le webhook répond en moins de trois secondes ». La contrainte technique reste nécessaire, mais elle n'est qu'un maillon du résultat.
Chaque voie de reprise doit être exercée. Une DLQ jamais relue, un curseur jamais restauré ou une resynchronisation jamais testée donne une assurance théorique. Les exercices contrôlés vérifient le propriétaire, le temps de reprise, la capacité à rejouer sans double effet et la qualité des preuves conservées.
Choisir par scénario, puis concevoir la convergence
Pour une seule application SaaS, un volume modéré et un délai de quelques secondes, un webhook signé vers une inbox durable, complété par une réconciliation périodique, constitue souvent le meilleur point de départ. Il reste compréhensible, limite l'infrastructure et apporte un chemin de reprise explicite.
Lorsque la source ne fournit pas de webhook fiable, un polling delta est préférable à un faux temps réel fragile. Le système adapte la fréquence au niveau d'urgence, protège ses curseurs et surveille le retard. Un polling complet n'est retenu que si le volume et les quotas rendent son coût acceptable.
Lorsque plusieurs équipes consomment les mêmes événements, que les pics dépassent la capacité d'un endpoint direct ou que le replay est une exigence, un flux durable devient justifié. La décision inclut alors le modèle de partition, la rétention, les schémas, la déduplication et l'exploitation des DLQ. Le broker n'est pas ajouté pour moderniser le dessin d'architecture.
Enfin, certains travaux ne devraient pas être déclenchés à chaque changement. Une clôture journalière, un contrôle périodique ou une consolidation peut rester planifié, car la cadence elle-même constitue une règle métier. L'autonomie consiste aussi à ne pas réagir inutilement.
Conclusion
Choisir entre webhook, polling et flux d'événements revient à décider comment le travail sera détecté, conservé, repris et prouvé. Le push apporte la rapidité, le polling par état apporte le rattrapage, et le flux apporte durabilité, fan-out et replay lorsque l'échelle le justifie. Aucun canal ne remplace la déduplication, l'idempotence, la politique d'accès ou la réconciliation.
La prochaine étape est de prendre un seul processus et d'écrire son contrat de cohérence : perte maximale acceptable, délai attendu, identifiant métier, source de vérité, règles de reprise et effets nécessitant une validation. Ce contrat permet ensuite de choisir l'architecture la plus simple qui garantit le résultat, puis de tester les interruptions avant de connecter l'équipe autonome aux opérations réelles.
Sources primaires et références
Microsoft Graph, Receive change notifications through webhooks, documentation mise à jour en 2026
Microsoft Graph, Reduce missing subscriptions and change notifications, documentation mise à jour en 2026
GitHub Docs, Best practices for using webhooks, documentation active en septembre 2026
Google Cloud Pub/Sub, Subscription overview, mise à jour du 26 août 2026
Amazon EventBridge, How EventBridge retries delivering events, documentation active en septembre 2026
CloudEvents, spécification commune des données d'événements, version 1.0.2
Atlensia, plateforme pour équipes autonomes en entreprise, 2026