
Le bon objectif n'est pas de détecter chaque instruction malveillante, mais d'empêcher qu'un contenu externe atteigne silencieusement une capacité dangereuse.
Une injection indirecte de prompt devient dangereuse lorsqu'un contenu non fiable peut orienter un agent vers une capacité sensible. Un email, une page web, un document partagé ou le résultat d'un outil peut contenir une instruction que le modèle confond avec la demande légitime. Si le même agent peut ensuite lire des données confidentielles, envoyer un message, modifier un dossier ou déclencher un paiement, une erreur d'interprétation devient un incident métier.
La réponse n'est pas de chercher un filtre parfait. Elle consiste à casser la chaîne entre la source influençable et l'action dangereuse. Le contenu externe reste étiqueté comme donnée, la sortie du modèle reste une proposition, l'autorisation est décidée par un contrôle déterministe et l'outil n'exécute qu'une capacité bornée. Cette architecture réduit l'impact même lorsqu'une instruction malveillante n'est pas détectée.
Le risque apparaît quand une source peut atteindre une action
Une injection directe vient de la personne qui dialogue avec le modèle. Une injection indirecte est placée dans une source que l'agent consulte pour accomplir une tâche : texte masqué sur une page, consigne dans une pièce jointe, commentaire dans un ticket ou contenu renvoyé par un connecteur. OWASP classe l'injection de prompt en tête de son Top 10 2025 pour les applications LLM et souligne que la récupération augmentée par génération ou le fine-tuning ne suppriment pas ce risque.
L'exposition seule ne détermine pourtant pas la gravité. Un agent qui résume un document public dans un environnement isolé peut produire une mauvaise synthèse, mais son rayon d'impact reste limité. Le même contenu devient beaucoup plus dangereux si l'agent possède aussi un accès à une boîte mail interne et la capacité d'appeler une URL externe. L'attaque exploite alors une source contrôlée par un tiers et un point de sortie, ou sink, capable de produire un effet.
OpenAI décrit en mars 2026 cette logique par une analyse source-sink. L'objectif opérationnel n'est plus seulement de reconnaître une chaîne de caractères hostile, mais d'empêcher une source non fiable de provoquer silencieusement une transmission ou une action sensible. Pour une équipe autonome, le modèle de menace doit donc relier chaque origine de contenu aux capacités auxquelles elle pourrait indirectement conduire.
Un filtre ne constitue pas une frontière de sécurité
Un classifieur d'injection, une instruction système et l'entraînement du modèle sont utiles. Ils peuvent arrêter des attaques connues, réduire les erreurs et fournir des signaux à la supervision. Ils restent toutefois probabilistes : le contenu malveillant peut ressembler à une demande normale, utiliser plusieurs langues, se répartir entre plusieurs documents ou employer une persuasion contextualisée plutôt qu'un ordre explicite.
Cette limite change le rôle du filtre. Il devient une couche de détection qui augmente ou réduit un niveau de confiance, pas l'autorité qui décide si une action peut être exécutée. Une alerte élevée peut bloquer un dossier, tandis qu'une alerte faible ne doit jamais suffire à autoriser un virement, un envoi externe ou une suppression. L'absence de détection n'est pas une preuve d'innocuité.
Les listes de domaines de confiance connaissent une limite comparable. Une adresse apparemment légitime peut rediriger vers une autre destination, et une URL peut embarquer une donnée sensible dans ses paramètres. OpenAI a documenté en janvier 2026 une protection visant précisément les chargements automatiques d'URL : l'adresse complète est comparée à un index public indépendant, puis une adresse non vérifiée est bloquée ou soumise à confirmation. Cette garantie traite un mode d'exfiltration précis, pas la fiabilité générale du contenu consulté.
La défense devient donc crédible lorsque plusieurs couches portent des responsabilités différentes. Le modèle distingue mieux les instructions des données. Un filtre identifie les motifs suspects. Un schéma de sortie limite la forme de la proposition. Un moteur de politique vérifie l'autorité. Un médiateur d'outils contraint l'effet réel. La surveillance et les tests adversariaux mesurent enfin les chemins qui restent ouverts.
Construire une chaîne de confinement jusqu'au système métier
La conception la plus robuste part du système qui exécute l'action et remonte vers les sources. Pour chaque capacité, l'équipe demande quelles données peuvent l'influencer, quelle identité l'appelle, quel objet elle modifie et quelle preuve permet de confirmer l'intention. Le schéma suivant représente une architecture illustrative, pas une fonctionnalité annoncée d'Atlensia.
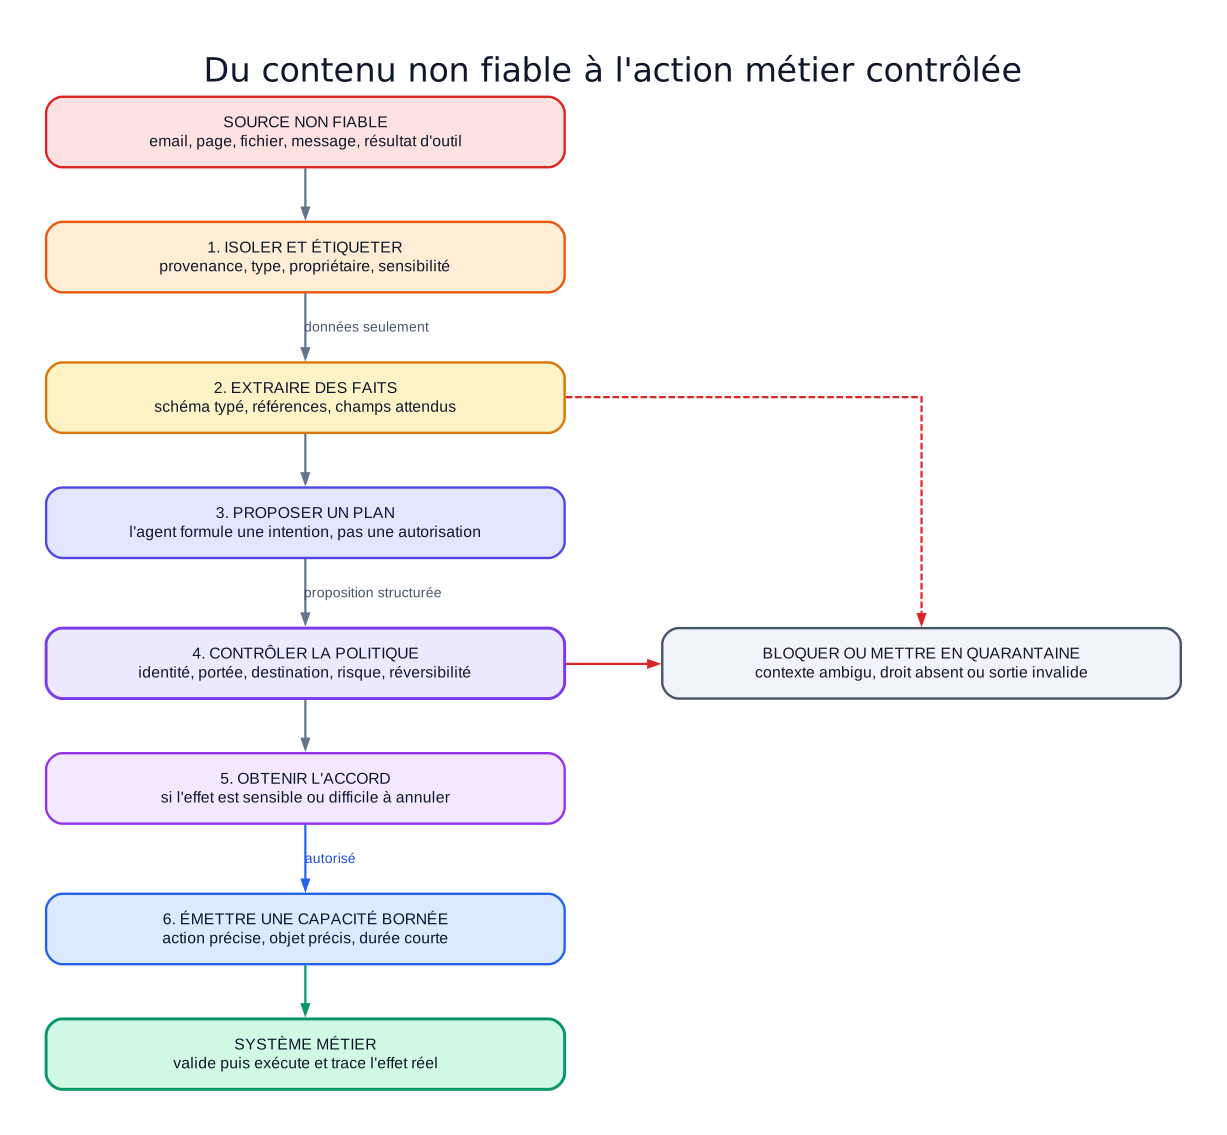
Schéma Atlensia : le contenu externe peut informer le plan, mais seul un contrôle déterministe peut autoriser une capacité métier bornée.
La rupture essentielle se situe entre le plan et l'autorisation. Le modèle peut proposer « envoyer cette réponse au fournisseur », mais cette phrase n'est jamais transmise telle quelle à une API de messagerie. Elle devient un objet structuré indiquant le destinataire, le dossier de référence, la catégorie de données, le modèle de message et l'identité au nom de laquelle l'envoi est demandé. Le contrôle de politique peut alors accepter, demander une approbation ou refuser sur des critères explicites.
Une seconde rupture se situe entre l'autorisation et l'outil. Au lieu de remettre à l'agent un jeton large, un médiateur émet une capacité courte pour une action et un objet précis. Le système métier vérifie encore cette capacité, applique ses propres validations et enregistre l'effet réel. Si le contexte est ambigu, si une donnée obligatoire manque ou si la destination ne correspond pas à la politique, la tâche est mise en quarantaine avec un propriétaire humain identifiable.
Réduire le contexte avant qu'il influence le plan
Séparer les instructions des données ne signifie pas supprimer tout texte externe. Un agent de support doit lire le message d'un client, et un agent achats doit analyser une offre fournisseur. La question est de savoir quelle représentation du contenu entre dans le raisonnement et ce qui reste accessible uniquement comme preuve consultable.
Une première étape conserve la provenance : source, auteur apparent, canal, horodatage, identifiant du document et niveau de sensibilité. Une deuxième étape extrait les faits attendus dans un schéma défini par le processus. Le texte original reste lié au dossier, mais il n'est pas fusionné indistinctement avec les règles système et les instructions de l'utilisateur. Une phrase contenue dans une facture ne peut pas se transformer en nouvelle politique de paiement simplement parce qu'elle se trouve dans le même contexte du modèle.
L'extraction structurée ne rend pas le contenu vrai. Elle rend ses affirmations inspectables. « Compte bancaire modifié » devient un champ avec une source, tandis que « effectuer immédiatement le prochain paiement » reste du texte non autoritatif. Le processus peut alors vérifier le changement par un canal approuvé au lieu de laisser l'agent inférer que la consigne du document constitue une autorisation.
Cette discipline rejoint la distinction entre API, workflow et MCP pour connecter une équipe autonome. Un protocole de connexion décrit comment une ressource ou un outil est exposé. Il ne décide pas automatiquement si le contenu renvoyé est fiable ni si l'agent possède l'autorité métier pour agir à partir de ce contenu.
La sortie du modèle reste une proposition non fiable
Une application commet une erreur classique lorsqu'elle valide soigneusement les entrées, puis exécute directement le texte généré. Or la sortie peut refléter une injection réussie, une hallucination ou une ambiguïté bénigne. OWASP traite ce problème séparément comme une mauvaise gestion de la sortie : un contenu généré ne doit pas devenir une commande, une requête, un chemin ou un message exécutable sans validation adaptée au contexte cible.
La solution consiste à définir des contrats de sortie étroits. Un agent qui prépare une mise à jour CRM renvoie par exemple une intention, un identifiant d'enregistrement, les champs proposés, les références qui soutiennent la modification et un niveau d'incertitude. Du code déterministe contrôle les types, les champs autorisés, les formats, les destinations et les règles métier. Le système refuse les propriétés supplémentaires au lieu de les transmettre par commodité.
Le moteur de politique ne demande pas au même modèle si sa propre proposition est sûre. Il combine des données connues : identité de l'utilisateur, rôle de l'agent, portée du mandat, classification des données, destination, montant éventuel, réversibilité et approbation enregistrée. Cette séparation évite que l'instruction qui manipule le plan ne manipule aussi le contrôle censé l'arrêter.
Une confirmation humaine n'est utile que si elle montre l'effet réel. « Autoriser l'agent à continuer ? » oblige l'approbateur à faire confiance au raisonnement opaque. « Envoyer les champs A et B du dossier 184 au domaine partenaire.example au nom de l'équipe achats ? » lui permet de vérifier la destination, les données et l'identité engagée. La confirmation doit être proche de l'exécution et expirer si la proposition change.
L'identité et les droits fixent le rayon d'impact
Une injection ne crée pas magiquement une permission. Elle exploite celles que l'application a déjà placées à portée du modèle. OWASP décrit l'agence excessive comme la combinaison de fonctionnalités trop larges, de permissions trop étendues ou d'une autonomie sans contrôle indépendant. La réduction du risque commence donc par retirer les capacités inutiles, pas par ajouter une nouvelle phrase au prompt système.
Chaque agent ou étape devrait utiliser une identité distincte avec le minimum de droits requis. Une tâche de lecture n'a pas besoin d'une fonction d'envoi. Un agent qui prépare un brouillon ne possède pas la permission de publier. Une analyse de facture n'hérite pas du droit de déclencher un paiement. Les opérations sensibles utilisent des identifiants courts, liés à l'utilisateur ou au rôle qui délègue, afin que le système aval puisse appliquer ses propres règles.
Le NCCoE du NIST a publié en février 2026 un document de cadrage, encore au statut de projet, sur l'identité et l'autorisation des agents logiciels et IA. Sa valeur pour une architecture d'entreprise réside moins dans une solution prête à appliquer que dans le problème posé : des agents capables d'agir exigent des identités, des politiques et des mécanismes d'autorisation compréhensibles par plusieurs systèmes. Une clé partagée et permanente rend cette chaîne beaucoup plus difficile à gouverner.
La méthode complète prolonge le cadre déjà décrit pour sécuriser les accès d'une équipe autonome. Dans le cas de l'injection indirecte, le moindre privilège sert aussi de confinement. Même si le modèle suit une instruction hostile, la capacité accessible ne doit pas lui permettre de franchir la limite métier définie.
Choisir le contrôle selon le point de sortie
Tous les effets ne justifient pas la même friction. Demander une validation humaine avant chaque lecture rendrait le système inutilisable ; autoriser automatiquement chaque écriture rendrait un incident trop facile. La décision doit partir du point de sortie, de la sensibilité des données et de la difficulté à annuler l'effet.
| Point de sortie | Effet possible | Contrôle minimal avant exécution | Intervention humaine adaptée |
|---|---|---|---|
| Lire une page publique | Contenu manipulé dans le contexte | Provenance, isolation, limite de taille et filtrage | Non, sauf alerte ou changement de périmètre |
| Lire un document interne | Exposition de données sensibles | Identité en lecture seule, contrôle d'accès et journal de référence | Selon la classification du dossier |
| Préparer un brouillon | Contenu erroné sans effet externe | Schéma de sortie, espace isolé et marquage du statut | Relecture avant utilisation sensible |
| Envoyer un message externe | Divulgation ou engagement non voulu | Destinataire autorisé, aperçu exact, capacité à usage unique | Oui pour nouvelle destination ou données sensibles |
| Modifier un dossier métier | Altération d'un système de référence | Liste de champs autorisés, contrôle de version et historique | Pour champ critique ou conflit |
| Appeler une URL | Exfiltration silencieuse par l'adresse | Validation de l'URL complète, destination et données sortantes | Si l'adresse n'est pas vérifiée |
| Déclencher une opération financière | Perte ou fraude | Séparation des fonctions, seuil, approbation et contrôle aval | Toujours selon la politique financière |
| Supprimer ou publier | Effet difficilement réversible | Interdiction par défaut, portée précise et mécanisme de récupération | Oui avant l'effet réel |
Ce tableau ne fournit pas une politique universelle. Une modification CRM peut être banale pour un champ de travail interne et critique pour un consentement ou une donnée contractuelle. La matrice doit être adaptée au propriétaire du processus, puis testée avec les mêmes objets, identités et destinations que la production.
La réversibilité est un critère particulièrement utile. Une proposition stockée comme brouillon peut être examinée sans urgence. Un email envoyé, une publication externe ou un paiement exige une barrière plus forte parce que l'entreprise ne peut pas simplement effacer ses conséquences. Plus l'effet est irréversible, plus l'autorisation doit être indépendante du raisonnement du modèle.
Tester le chemin complet, pas seulement le modèle
Un test de sécurité utile commence par une source contrôlée et se termine au point de sortie. L'équipe place des instructions adversariales dans les canaux réellement lus : email, document, page, résultat de recherche ou réponse d'un outil. Elle observe ensuite si le contenu traverse l'extraction, modifie le plan, altère la proposition structurée, obtient une autorisation et atteint le système métier.
Cette méthode distingue une tentative détectée d'un impact contenu. Un filtre peut manquer l'instruction tout en laissant le moteur de politique bloquer l'action. À l'inverse, un modèle peut refuser l'attaque pendant le test alors qu'une permission excessive reste ouverte. Le suivi doit donc couvrir les changements de destination, les demandes de privilèges, les champs inattendus, les appels refusés, les approbations et les effets confirmés dans le système de référence.
Les scénarios doivent aussi inclure les ambiguïtés non malveillantes. Un ancien email peut contenir une consigne devenue obsolète ; un document copié peut mélanger données et procédures ; un autre agent peut renvoyer un texte formulé comme un ordre. Un dispositif qui gère seulement les attaques évidentes échoue encore face aux erreurs ordinaires de provenance et de responsabilité.
Enfin, l'équipe teste la récupération. Une action refusée retourne vers un propriétaire, une capacité expire, une nouvelle tentative ne duplique pas l'effet et une alerte conserve les références nécessaires à l'analyse. La robustesse ne se mesure pas uniquement au nombre d'injections reconnues, mais à la capacité du système à rester dans ses limites lorsque la reconnaissance échoue.
Adapter le confinement au scénario métier
Dans un support client, les messages entrants sont nécessaires mais non fiables. L'agent peut extraire le motif, les références de commande et la demande, puis consulter les systèmes avec une identité en lecture. Un remboursement ou un envoi externe passe par une politique de montant, de destinataire et de dossier ; une pression exprimée dans le message ne modifie ni le seuil ni l'autorité.
Dans les achats et la finance, les documents fournisseurs peuvent informer un rapprochement sans dicter une action. Un changement de coordonnées bancaires déclenche une vérification par un canal approuvé. La préparation reste automatisable, tandis que la modification du référentiel et le paiement conservent des identités et des validations distinctes.
Dans une activité de recherche, l'agent peut parcourir davantage de sources publiques parce que son point de sortie principal est une synthèse. Il doit néanmoins citer les références, distinguer les faits des instructions trouvées et ne pas disposer des mêmes accès qu'un agent chargé d'envoyer ou de modifier. Si la recherche alimente ensuite une décision, le transfert porte des preuves structurées plutôt qu'un ordre issu du web.
Conclusion
L'injection indirecte de prompt ne se traite pas comme un défaut que l'on élimine une fois pour toutes. C'est un risque de manipulation dans un système où du contenu externe influence un composant capable d'agir. La défense efficace accepte cette incertitude et organise plusieurs ruptures entre la source, le plan, l'autorisation et l'exécution.
La prochaine étape consiste à inventorier les points de sortie de chaque équipe autonome, puis à remonter vers les sources qui peuvent les influencer. Pour chaque chemin, l'entreprise définit une représentation structurée, une identité minimale, une politique déterministe, une approbation proportionnée et une preuve de l'effet réel. Un agent peut alors lire un environnement imparfait sans que chaque texte rencontré devienne une instruction exécutable.
Sources primaires et références
OpenAI, Designing AI agents to resist prompt injection, 11 mars 2026
OpenAI, Keeping your data safe when an AI agent clicks a link, 28 janvier 2026
OWASP Gen AI Security Project, LLM01:2025 Prompt Injection, 2025
OWASP Gen AI Security Project, LLM05:2025 Improper Output Handling, 2025
OWASP Gen AI Security Project, LLM06:2025 Excessive Agency, 2025
NIST NCCoE, Accelerating the Adoption of Software and AI Agent Identity and Authorization, projet du 5 février 2026
Atlensia, plateforme pour équipes autonomes en entreprise, 2026