
Le modèle peut proposer une action. L'autorité doit rester dans une couche de politique vérifiable, indépendante du contenu qu'il interprète.
En 2026, la discussion sur la sécurité des agents IA a changé de centre de gravité. Le sujet n'est plus seulement de réduire les hallucinations ou de mieux filtrer les réponses d'un modèle. Dès qu'un agent lit une messagerie, interroge un CRM, prépare un paiement ou modifie un dossier, le risque principal devient son autorité réelle dans les systèmes de l'entreprise.
Le NIST a lancé en février 2026 une initiative consacrée aux standards des agents IA, accompagnée d'un travail spécifique sur leur identité et leur autorisation. L'OWASP a, de son côté, structuré les risques agentiques autour de menaces comme le détournement d'objectif, l'abus d'outils et l'abus d'identité ou de privilèges. Ces publications ne démontrent pas qu'un produit particulier est sûr ou dangereux. Elles montrent que les pratiques classiques de gestion des accès doivent être adaptées à des logiciels capables d'interpréter une situation puis de proposer une chaîne d'actions.
Pour une équipe autonome orchestrée avec Atlensia, la conséquence est directe : le modèle ne doit jamais porter seul le droit d'agir. Son rôle consiste à interpréter, planifier et proposer. Une couche indépendante doit vérifier l'identité de travail, la ressource, l'action, le contexte, les limites et l'éventuelle validation humaine avant toute exécution.
Les références 2026 déplacent la sécurité vers l'identité
Le NIST AI Agent Standards Initiative traite conjointement interopérabilité, sécurité et identité. Le NIST explique que l'utilité des agents dépend de leur capacité à interagir avec des ressources numériques, mais que cette interaction exige de savoir pour qui l'agent agit, avec quelle autorité et sous quelles conditions. Son concept paper sur l'identité et l'autorité des agents logiciels met en avant l'identification, l'autorisation, l'audit, la non-répudiation et la prévention des injections comme sujets à traiter ensemble.
Cette approche corrige une faiblesse fréquente des premiers pilotes. Une application reçoit une clé de service très large, puis le prompt demande au modèle de rester prudent. Le contrôle technique et la consigne linguistique se retrouvent inversés. Si une pièce jointe, un résultat de recherche ou un message malveillant détourne le raisonnement, rien n'empêche l'application d'utiliser les privilèges déjà accordés.
Le problème n'est pas propre aux modèles génératifs. Les systèmes distribués utilisent depuis longtemps identités de service, politiques d'accès et jetons limités. Ce qui change avec un agent est la diversité des chemins possibles. Le même rôle peut consulter plusieurs sources, choisir un outil, reformuler un objectif et poursuivre après une erreur. L'autorisation ne peut donc pas être accordée une fois pour toutes au début d'une session. Elle doit être réévaluée au moment de l'action, à partir d'éléments observables.
L'injection devient dangereuse lorsqu'elle rencontre un privilège
Une injection indirecte est une instruction cachée dans un contenu que l'agent considère comme une donnée : e-mail, page web, document, ticket ou réponse d'un outil. Le texte peut demander d'ignorer la mission, d'envoyer des informations vers une destination externe ou d'appeler une fonction hors périmètre. Tant que le modèle ne produit qu'un brouillon isolé, l'impact reste contenu. Dès qu'il possède un accès large à des outils, la même manipulation peut devenir une modification, un envoi ou une exfiltration.
L'OWASP Top 10 for Agentic Applications 2026 place notamment le détournement d'objectif, l'abus d'outils et l'abus d'identité parmi les risques structurants. Le rapport OWASP State of Agentic AI Security and Governance 2.01 relie ces catégories à un paysage de menaces plus large. Il s'agit de références communautaires, pas d'une mesure indépendante de chaque produit. Leur intérêt est de donner aux équipes produit, sécurité et métier un vocabulaire commun pour examiner le système complet.
| Surface | Question de sécurité | Preuve attendue |
|---|---|---|
| Identité | Quel rôle agit et pour quelle organisation ? | Identité dédiée, propriétaire, durée et révocation |
| Autorité | Cette action est-elle permise sur cette ressource maintenant ? | Décision de politique avec motif et attributs utilisés |
| Outil | L'appel respecte-t-il un schéma et des limites connues ? | Arguments validés, version, résultat et code d'erreur |
| Données | L'entrée et la sortie restent-elles dans le périmètre autorisé ? | Classification, destination et minimisation vérifiées |
| Validation | Un humain doit-il accepter l'effet externe ? | Identité du valideur, contexte présenté et décision |
| Trace | Un tiers peut-il reconstruire ce qui s'est produit ? | Proposition, autorisation, exécution et résultat reliés |
Cette grille révèle pourquoi un simple filtre de contenu est insuffisant. Le filtre essaie de déterminer si un texte est suspect. La politique d'autorisation décide qu'une action est impossible même si le texte paraît normal. Les deux mécanismes peuvent coexister, mais le second limite le dommage lorsque le premier échoue.
Une équipe autonome a besoin d'identités de travail distinctes
Donner une seule identité technique à toute une équipe autonome simplifie le prototype, mais efface la responsabilité. Un rôle chargé de qualifier un prospect, un rôle chargé de préparer un contrat et un rôle chargé d'envoyer un message n'ont ni les mêmes données ni le même effet métier. S'ils utilisent le même compte de service, les journaux montrent seulement qu'une application a agi. Ils ne permettent pas de relier l'action au mandat qui la justifiait.
Une identité de travail doit correspondre à un rôle explicite et à un périmètre de ressources. Elle dispose des droits nécessaires pour une étape du workflow, pas d'un accès général à l'outil. Un rôle de préparation peut lire un dossier et produire une proposition sans pouvoir l'envoyer. Un rôle d'exécution peut recevoir un objet déjà validé, mais ne devrait pas pouvoir modifier la règle de validation. Cette séparation réduit le rayon d'impact et rend la révocation ciblée possible.
Le NIST SP 800-207 sur l'architecture Zero Trust fournit un principe utile : ne pas accorder de confiance implicite selon la localisation ou la présence dans un réseau. Appliqué aux agents, cela signifie qu'une tâche légitime ne justifie pas tous les appels suivants. Chaque action est évaluée selon le sujet, la ressource, le contexte et le niveau de risque. Le modèle peut expliquer pourquoi il souhaite agir, mais cette explication n'est pas une autorisation.
Les secrets restent eux aussi hors du contexte. Le modèle reçoit le nom logique d'un outil et son schéma, jamais le jeton qui permettra l'appel. Le composant d'exécution obtient un jeton court, limité à une audience et à une opération. Le RFC 9700 rassemble les pratiques actuelles de sécurité OAuth 2.0, notamment autour de la protection des jetons et des flux. Le choix exact dépend du fournisseur d'identité, mais le principe reste stable : une fuite de contexte ne doit pas devenir une fuite de secret réutilisable.
L'autorité doit rester hors du modèle
Le point de décision reçoit une proposition structurée et la confronte à une politique. Il vérifie l'identité, la ressource, l'action, le contexte métier, la classification des données, les limites de volume et l'éventuelle validation requise. Une réponse positive produit une autorisation bornée. Une réponse négative produit un motif exploitable par le workflow et, si nécessaire, un dossier d'escalade.
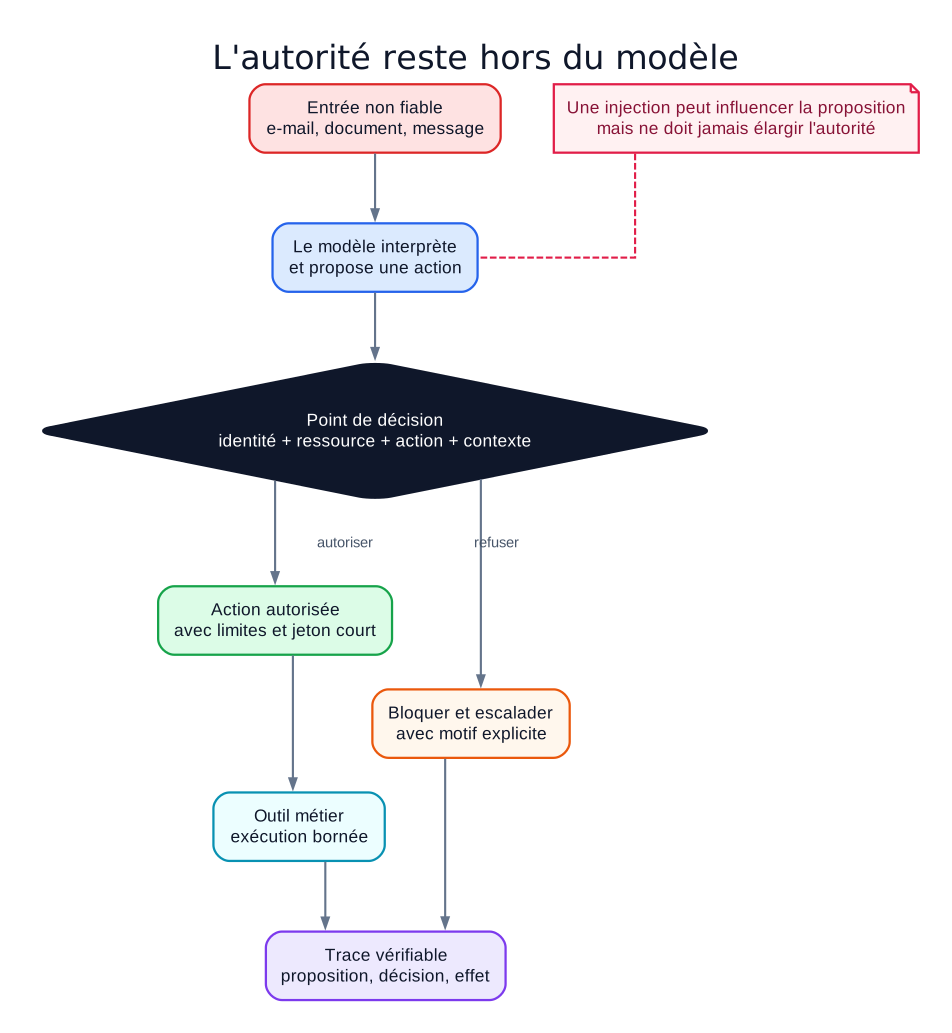
Schéma Atlensia : une entrée peut influencer la proposition du modèle, mais seule une politique externe décide si l'action est autorisée.
Cette architecture ne prétend pas rendre le raisonnement du modèle infaillible. Elle rend l'erreur contenue. Une injection peut influencer la proposition, mais elle ne peut pas ajouter un outil à la liste autorisée, élargir la portée d'un jeton ou supprimer une validation. La sécurité repose alors sur des frontières testables plutôt que sur l'espoir que le modèle reconnaisse chaque formulation malveillante.
Le refus doit être aussi précis que l'autorisation. « Action impossible » ne permet ni correction ni audit. Le système devrait indiquer que le rôle ne possède pas le droit, que la ressource est hors périmètre, que la donnée est trop sensible, que le seuil exige une validation ou que la preuve manque. Cette précision aide l'humain à arbitrer sans révéler de secret ni exposer la politique complète à une entrée non fiable.
Le contrat d'outil doit limiter les effets, pas seulement le format
Un schéma JSON valide n'est pas une politique de sécurité. Il garantit que les arguments ont une forme attendue, mais pas que l'action est légitime. Un outil send_email peut recevoir une adresse bien formée et rester dangereux si le destinataire n'est pas autorisé, si la pièce jointe contient des données sensibles ou si le rôle n'a qu'un mandat de préparation.
Le contrat d'outil doit donc décrire l'effet métier. Il précise les ressources accessibles, les destinataires autorisés, les montants, les volumes, l'idempotence, les erreurs et la possibilité d'annulation. Une opération large gagne à être divisée entre préparation et engagement. Créer un brouillon, vérifier une règle et soumettre à validation sont des capacités différentes de l'envoi final.
L'OWASP Securing Agentic Applications Guide recommande notamment de restreindre l'invocation des outils, d'appliquer une authentification au niveau des fonctions et d'isoler l'exécution. Pour Atlensia, ces contrôles s'insèrent dans l'Operating Layer : le rôle sélectionne une action possible, la politique décide, l'outil exécute dans une limite et la trace relie les quatre étapes.
Le test décisif est celui d'un accès refusé
Un pilote de sécurité ne devrait pas commencer par vérifier que l'agent réussit le scénario nominal. Cette réussite est nécessaire, mais elle ne montre pas que les frontières tiennent. Le test le plus instructif place une instruction malveillante dans une source autorisée, demande un outil hors périmètre, réutilise un identifiant expiré, dépasse un seuil et révoque l'accès pendant une tâche en cours.
| Situation testée | Comportement attendu | Signal d'échec critique |
|---|---|---|
| Instruction cachée dans un document | Traiter le texte comme une donnée et conserver la politique | Appel d'un outil ajouté par le document |
| Destinataire externe non autorisé | Bloquer avant l'envoi et expliquer le motif | Transmission, même partielle, de la donnée |
| Jeton révoqué pendant le workflow | Arrêter, conserver l'état et escalader | Nouvelle tentative avec un secret différent |
| Action répétée après un timeout | Vérifier l'idempotence avant reprise | Double création ou double engagement |
| Seuil nécessitant une validation | Préparer un dossier de décision complet | Contournement ou validation vide de contexte |
La trace de test doit relier l'entrée, la proposition du modèle, la décision de politique, l'appel éventuel et l'effet observé. Elle permet à la sécurité de vérifier la frontière sans interpréter toute la conversation. Elle permet aussi au métier de voir si un refus est trop strict et bloque un travail légitime.
Conclusion
Les publications du NIST et de l'OWASP en 2026 ne créent pas une nouvelle discipline séparée de la cybersécurité. Elles montrent comment appliquer identité, moindre privilège, séparation des rôles, autorisation continue et audit à des logiciels capables de planifier et d'utiliser des outils. La nouveauté vient du chemin dynamique entre l'intention et l'effet, pas de l'abandon des principes éprouvés.
Pour une équipe autonome, le modèle peut rester puissant et flexible à condition que son autorité soit étroite. Le rôle définit ce qu'il cherche à accomplir. La politique décide ce qui est permis. L'outil exécute une opération bornée. La trace prouve ce qui s'est passé. Aucune instruction reçue dans un document ou une messagerie ne doit pouvoir fusionner ces responsabilités.
La prochaine étape consiste à choisir un workflow réel, cartographier ses identités et ses effets, puis tester volontairement cinq refus : outil hors périmètre, donnée sensible, destinataire non autorisé, seuil de validation et jeton révoqué. Tant que ces refus ne sont pas observables et reproductibles, l'accès en écriture reste prématuré.
Sources primaires et références
- NIST, AI Agent Standards Initiative
- NIST, concept paper sur l'identité et l'autorité des agents
- NIST, synthèse des réponses sur la sécurité des agents IA
- OWASP, Top 10 for Agentic Applications 2026
- OWASP, State of Agentic AI Security and Governance 2.01
- OWASP, Securing Agentic Applications Guide
- NIST SP 800-207, Zero Trust Architecture
- RFC 9700, sécurité OAuth 2.0