
Le bon modèle n'est pas un vainqueur universel. C'est une ressource gouvernée à l'intérieur d'un système de travail mesurable et remplaçable.
Au moment de concevoir une équipe autonome, beaucoup d'organisations commencent par une question apparemment logique : quel est le meilleur modèle ? Cette formulation conduit pourtant à une mauvaise décision d'architecture. Elle transforme un composant rapidement remplaçable en fondation du système, alors que la réussite dépend d'abord du travail confié, des outils autorisés, des règles de décision et de la manière dont les résultats seront contrôlés.
Les fournisseurs eux-mêmes proposent désormais plusieurs niveaux de modèles. OpenAI distingue des variantes orientées capacité, équilibre et efficacité. Anthropic positionne plusieurs familles selon la complexité, la vitesse et le coût. Google et Mistral organisent aussi leurs catalogues autour de profils différents. Cette évolution ne signifie pas qu'une entreprise doit multiplier les fournisseurs. Elle montre surtout qu'aucun modèle n'est optimal pour toutes les tâches d'une même équipe.
Pour Atlensia, la question utile devient donc : quelle politique permet d'attribuer le bon niveau de modèle à chaque travail, tout en conservant les mêmes rôles, permissions, validations et preuves ? La réponse ne se trouve ni dans un classement public ni dans la taille de la fenêtre de contexte. Elle se construit dans l'Operating Layer, là où l'organisation sépare l'objectif métier du moteur qui produit une proposition.
Le modèle n'est pas l'équipe autonome
Un modèle produit une réponse ou demande l'appel d'un outil. Il ne possède pas, à lui seul, un mandat légitime dans l'entreprise. Même lorsqu'un fournisseur parle d'agent ou de tool use, l'exécution réelle dépend d'une application qui expose les outils, vérifie les arguments, applique les permissions et traite le résultat. La documentation Anthropic sur l'utilisation des outils décrit explicitement ce contrat : le modèle émet une demande structurée, puis l'application ou le service exécute l'opération. Cette séparation est fondamentale pour une équipe autonome, car elle empêche de confondre capacité de raisonnement et autorité d'agir.
Le principe d'Operating Layer présenté par Atlensia conduit à placer le modèle à l'intérieur d'un système de travail plus large. Le rôle définit la mission. La politique précise les données et les outils accessibles. Les validations protègent les effets sensibles. Les traces permettent de reconstruire la décision. Dans cette architecture, changer de modèle ne devrait pas modifier le contrat métier, pas plus qu'un changement de moteur de recherche ne devrait redéfinir la responsabilité d'une équipe juridique ou commerciale.
Cette distinction protège aussi l'entreprise contre une dépendance plus subtile que le simple verrouillage fournisseur. Un prompt peut accumuler des hypothèses propres à un modèle, des formats implicites, des contournements de bugs et des outils décrits selon une syntaxe particulière. Après quelques mois, le workflow semble portable sur le papier mais ne l'est plus réellement. La dépendance se trouve alors dans les détails du comportement, pas seulement dans l'API appelée.
Le bon objet de gouvernance n'est donc pas « le modèle de l'entreprise ». C'est une configuration versionnée qui relie une catégorie de tâche à un modèle, un niveau de raisonnement, un jeu d'outils, une politique de données, des seuils d'acceptation et une route de repli. Cette configuration peut évoluer sans réécrire le mandat de l'équipe autonome.
Trois architectures produisent trois formes de risque
Une organisation peut exploiter un seul modèle généraliste, plusieurs modèles d'une même famille ou un routeur capable de changer de fournisseur. Ces architectures ne représentent pas trois niveaux de maturité. Elles répondent à des contraintes différentes et déplacent le risque entre simplicité, coût, continuité et gouvernance.
| Architecture | Avantage principal | Risque structurel | Situation cohérente |
|---|---|---|---|
| Un modèle généraliste | Peu de variantes à intégrer et à superviser | Coût excessif sur les tâches simples, dépendance comportementale | Premier pilote étroit, volume limité, exigences homogènes |
| Une famille de modèles | Contrat fournisseur et outils souvent plus cohérents | Les écarts entre variantes doivent tout de même être évalués | Plusieurs niveaux de complexité dans un même environnement cloud |
| Plusieurs fournisseurs avec routage | Continuité, spécialisation et pouvoir de négociation | Complexité des politiques, des données, des traces et des tests | Volume significatif, exigences régionales ou besoin de résilience |
Le modèle unique est souvent le meilleur point de départ, mais rarement une cible définitive. Il réduit le nombre de variables pendant que l'équipe apprend à définir ses outils et ses critères de réussite. Son défaut apparaît lorsque chaque tâche, y compris la classification simple ou l'extraction structurée, paie le coût et la latence d'un modèle choisi pour les cas les plus difficiles. L'entreprise finance alors une capacité inutilisée sans améliorer le résultat accepté.
Une famille de modèles introduit un premier niveau de routage sans changer de contrat commercial principal. Les catalogues actuels d'OpenAI, Anthropic, Google et Mistral illustrent tous cette logique de gamme. L'avantage opérationnel vient moins des noms de modèles que de la possibilité de réserver la capacité la plus élevée aux dossiers ambigus, tout en confiant le volume stable à une variante plus efficiente. Cette approche ne dispense pas d'évaluation : deux variantes d'une même famille peuvent différer dans le choix d'outil, le respect d'un format ou la manière de signaler l'incertitude.
Le routage multi-fournisseurs devient pertinent lorsque la continuité de service, la localisation, une modalité particulière ou un rapport coût-qualité mesuré justifie la complexité supplémentaire. Il impose cependant de normaliser les schémas d'outils, les erreurs, les limites et les traces. Sans cette couche, le routeur ne réduit pas la dépendance. Il la répartit entre plusieurs intégrations difficiles à comparer.
Les catalogues donnent des points de départ, pas un classement
Au 18 août 2026, les documentations officielles montrent des portefeuilles conçus pour plusieurs compromis. OpenAI présente GPT-5.6 Sol pour les travaux complexes, Terra pour équilibrer intelligence et coût, et Luna pour les charges sensibles au volume. Anthropic distingue notamment Claude Fable 5 et Opus 5 pour les tâches les plus exigeantes, Sonnet 5 pour un équilibre à grande échelle et Haiku 4.5 pour la vitesse. Google positionne Gemini 3.5 Flash sur les tâches agentiques soutenues, Gemini 3.6 Flash sur l'équilibre vitesse-intelligence et Flash-Lite sur le haut débit. Mistral propose aussi des modèles généralistes de tailles différentes ainsi que des modèles spécialisés.
| Fournisseur | Repère de forte capacité dans la documentation | Repère d'équilibre ou d'efficacité | Ce que l'entreprise doit encore prouver |
|---|---|---|---|
| OpenAI | GPT-5.6 Sol | GPT-5.6 Terra et Luna | Qualité sur les tâches privées, coût total, comportement des outils |
| Anthropic | Claude Fable 5 ou Opus 5 selon le besoin | Claude Sonnet 5 et Haiku 4.5 | Gain réel du niveau supérieur, latence, disponibilité par plateforme |
| Gemini 3.5 Flash pour les tâches soutenues | Gemini 3.6 Flash et Flash-Lite | Stabilité de la version, qualité multimodale, quotas du projet | |
| Mistral | Mistral Large 3 | Medium 3.1, Small 3.2 ou Ministral 3 | Niveau de spécialisation utile, option de déploiement, coût d'exploitation |
Ce tableau ne crée aucune équivalence de performance entre fournisseurs. Les catégories sont celles de leurs documentations et peuvent changer. Elles servent à sélectionner des candidats pour un test, pas à attribuer un vainqueur. Un modèle décrit comme plus puissant peut être moins fiable sur un outil interne mal documenté. Un modèle plus petit peut être supérieur sur une classification fermée, parce que la tâche exige de la stabilité plutôt qu'une longue délibération.
Les noms de version doivent aussi être traités comme des dépendances. Google distingue versions stables, preview, latest et expérimentales, avec des comportements de mise à jour différents. Anthropic documente des identifiants de modèles épinglés à partir de certaines générations. Les alias pratiques accélèrent l'expérimentation, mais une équipe autonome en production a besoin d'un identifiant vérifiable, d'une date de validation et d'une procédure de migration. Sinon, le comportement peut changer sans décision explicite de l'organisation.
L'évaluation doit reproduire le travail, les outils et les refus
Comparer des réponses sur quelques questions générales mesure surtout la qualité d'une démonstration. Une équipe autonome doit être évaluée sur un ensemble de cas représentatifs du workflow réel, avec les mêmes documents, les mêmes outils, les mêmes permissions et le même format de sortie qu'en production. Les cas difficiles ne sont pas seulement ceux qui exigent davantage de raisonnement. Ils incluent les informations manquantes, les sources contradictoires, l'outil indisponible, la demande hors mandat et l'action qui doit être refusée.
L'unité de comparaison est le résultat accepté, pas le prix du million de jetons. Un modèle moins cher peut provoquer davantage de tentatives, d'appels d'outils ou de reprises humaines. Un modèle plus coûteux peut réduire ces étapes, sans que ce gain compense nécessairement sa latence. Il faut donc mesurer le coût de la trajectoire complète, depuis l'entrée du dossier jusqu'à sa validation ou son escalade.
| Mesure | Question de décision |
|---|---|
| Réussite de la tâche | Le résultat fait-il progresser le dossier selon le critère métier ? |
| Appel d'outil correct | Le bon outil est-il choisi avec des arguments valides et autorisés ? |
| Refus et escalade | Le modèle s'arrête-t-il lorsque la preuve ou l'autorisation manque ? |
| Correction humaine | Quel temps reste nécessaire avant acceptation ? |
| Latence de bout en bout | Le délai reste-t-il compatible avec le workflow, y compris au 95e percentile ? |
| Coût par résultat accepté | Combien coûtent modèle, outils, reprises, traces et supervision ? |
| Stabilité | Les résultats restent-ils acceptables sur plusieurs exécutions et versions ? |
Les plateformes proposent leurs propres moyens d'évaluation, comme les Evals d'OpenAI, l'outil d'évaluation de Claude ou les services d'évaluation de Vertex AI. Ces outils peuvent accélérer l'exécution, mais la définition du succès appartient à l'entreprise. Le NIST AI Risk Management Framework rappelle que la mesure s'inscrit dans un processus plus large de cartographie, de gouvernance et de traitement du risque. Une note moyenne ne remplace donc pas l'analyse des échecs graves.
Un routeur n'est utile que si sa décision est explicable
Le routeur ne devrait pas demander à un modèle de choisir librement un autre modèle à partir d'une consigne vague. Il applique une politique observable à des attributs déjà qualifiés : type de tâche, sensibilité des données, effet externe, complexité, modalité, délai, budget et niveau de preuve. Certains attributs viennent du workflow, d'autres d'un classificateur contrôlé. Tous doivent pouvoir être retrouvés dans la trace.
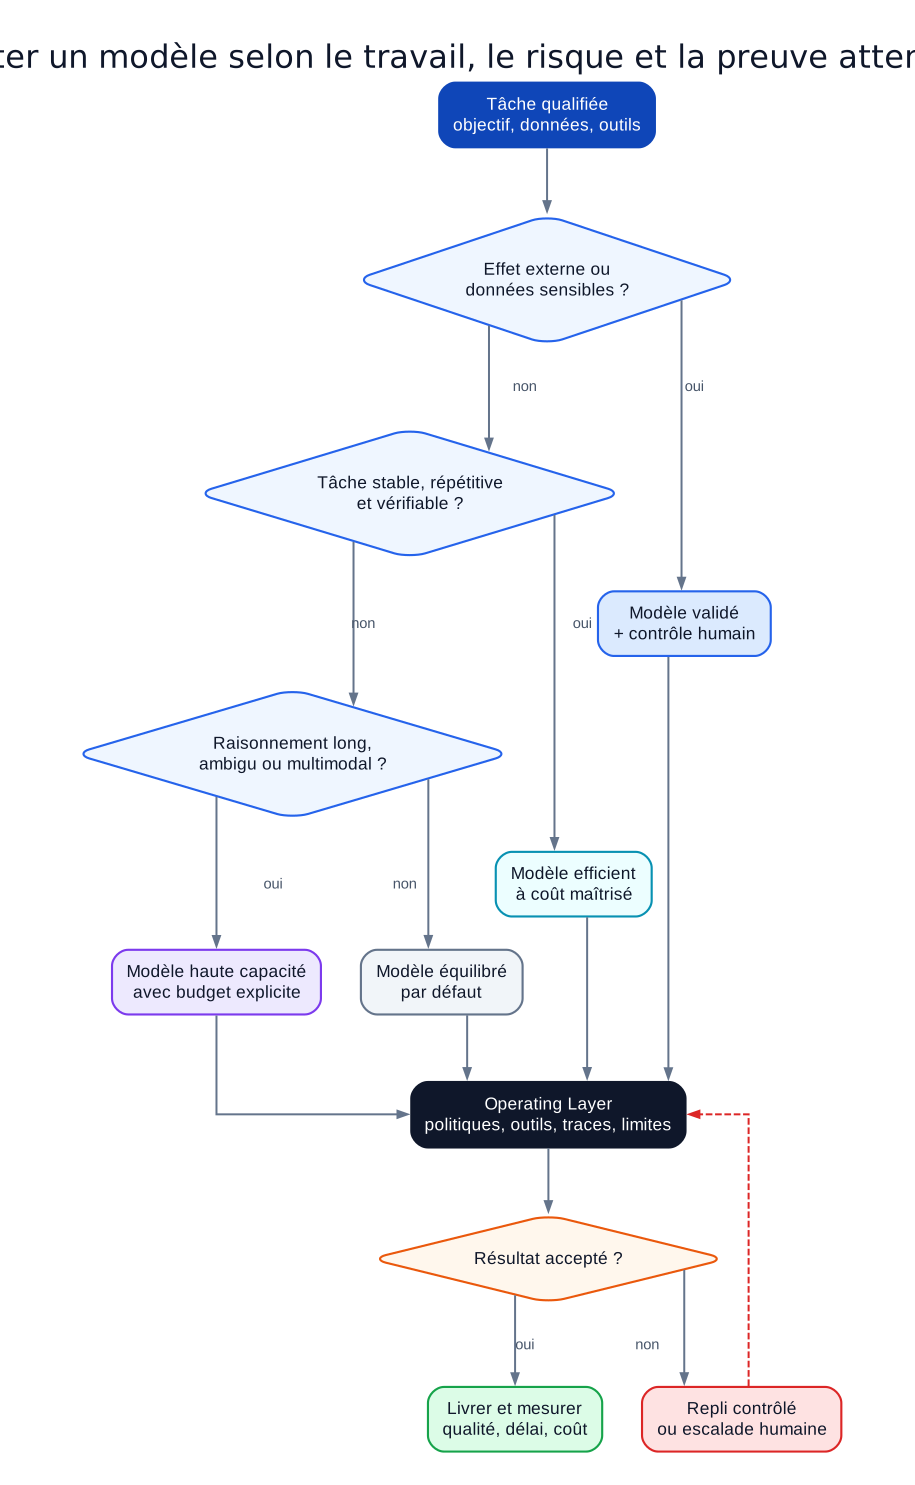
Schéma Atlensia : le modèle est choisi après qualification du travail, puis encadré par les politiques, outils, limites et traces de l'Operating Layer.
Le schéma met en évidence une règle importante : le risque ne sélectionne pas automatiquement le modèle le plus puissant. Il sélectionne d'abord le niveau de contrôle. Une tâche qui engage l'entreprise ou manipule des données sensibles doit utiliser une configuration validée et, lorsque l'impact le justifie, une décision humaine. La capacité du modèle ne supprime ni l'autorisation ni la responsabilité.
Le repli doit être conçu comme une décision métier. Après un échec, appeler silencieusement un second modèle peut doubler le coût, transmettre les données à un autre fournisseur ou produire deux actions concurrentes. La route de repli précise donc ce qui peut être retenté, avec quel fournisseur, après quelle erreur et sous quelle limite. Pour une action externe, l'échec doit souvent conduire à l'escalade plutôt qu'à une nouvelle tentative automatique.
L'Operating Layer doit rendre le modèle remplaçable
Une architecture alignée sur Atlensia conserve le mandat, les outils et les règles en dehors de la configuration fournisseur. Le registre de modèles associe un identifiant épinglé à une date de validation, aux régions autorisées, aux modalités disponibles, aux conditions de traitement des données, aux limites de contexte, aux outils supportés et au jeu d'évaluation réussi. Ce registre ne dit pas seulement ce qui est techniquement accessible. Il dit ce qui est autorisé pour un rôle et un workflow donnés.
Les schémas d'outils forment ensuite une interface stable. Un outil de création de commande, par exemple, garde les mêmes champs métier et les mêmes validations quel que soit le modèle qui le demande. Un adaptateur peut traduire le format technique du fournisseur, mais il ne change pas la politique. Cette séparation rend les tests comparables et empêche un changement de modèle d'élargir implicitement le périmètre d'action.
Le contexte doit suivre la même logique. Les instructions de rôle, les règles de décision et les références métiers restent versionnées indépendamment du modèle. Les optimisations propres à un fournisseur sont isolées dans une couche d'adaptation et documentées comme telles. Lors d'une migration, l'équipe peut alors changer un seul facteur, relancer le même jeu d'évaluation et identifier la cause d'une régression.
Enfin, la trace relie chaque résultat à la configuration réellement utilisée : modèle, version, niveau de raisonnement, outils exposés, politique de routage, sources consultées, validations et route de repli. Sans cette information, une entreprise peut observer qu'un résultat a changé sans savoir si la cause vient du modèle, du prompt, d'un document, d'un outil ou d'une règle.
Passer du choix théorique à une décision d'architecture
Le premier test doit rester assez étroit pour produire une conclusion. Choisissez un workflow réel contenant du volume stable et quelques exceptions significatives. Conservez la même définition du rôle et les mêmes outils, puis comparez trois configurations : une référence simple, une variante plus efficiente et une variante de capacité supérieure. Le but n'est pas de tester tout le marché, mais d'identifier l'endroit où un changement de niveau améliore réellement le résultat accepté.
Exécutez d'abord les configurations sur des cas historiques ou synthétiques validés par des experts métier. Passez ensuite en mode observation sur des dossiers réels, sans autoriser d'effet externe. Les écarts les plus utiles ne sont pas toujours les mauvaises réponses. Ce sont souvent les appels d'outils inutiles, les refus manquants, les preuves insuffisantes ou les dossiers qui auraient dû être escaladés plus tôt.
La décision finale peut rester simple. Conserver un modèle unique si la qualité est homogène et si le volume ne justifie pas de routeur. Introduire une famille de modèles si les tâches stables supportent une variante plus efficiente sans dégrader les refus et les outils. Ajouter un second fournisseur seulement lorsqu'un besoin mesuré de résilience, de localisation ou de spécialisation couvre le coût opérationnel de cette nouvelle dépendance.
Conclusion
Une équipe autonome ne devient pas plus robuste parce qu'elle utilise le modèle le plus récent ou le plus puissant. Elle devient plus robuste lorsque l'organisation peut expliquer pourquoi une tâche a reçu une configuration donnée, quelles limites s'appliquaient et quelle preuve autorisait le résultat. Le modèle reste important, mais il n'est qu'une ressource dans une architecture de délégation.
Le modèle unique constitue une bonne base de départ lorsque le périmètre est étroit. Une famille de modèles devient utile lorsque le volume et la diversité des tâches font apparaître des compromis mesurables. Le routage multi-fournisseurs n'est justifié que par une exigence réelle de continuité, de localisation ou de spécialisation. Dans chaque cas, la bonne décision vient des mêmes cas de test et des mêmes critères métier.
Pour Atlensia, la valeur de l'Operating Layer est précisément de maintenir cette séparation. Le rôle, les permissions, les outils, les validations et les traces ne doivent pas être redéfinis à chaque changement de modèle. Cette stabilité extérieure permet de faire évoluer la capacité intérieure sans transformer chaque mise à jour fournisseur en projet de réorganisation.
La prochaine étape n'est donc pas de choisir un vainqueur dans un tableau public. Elle consiste à sélectionner un workflow, épingler trois configurations candidates et mesurer le résultat accepté, les refus, les appels d'outils, la latence et le coût total. Le routeur ne vient qu'après cette preuve.
Sources primaires et références
- Atlensia, Operating Layer
- OpenAI, catalogue des modèles
- OpenAI, Evals API
- Anthropic, choisir un modèle Claude
- Anthropic, identifiants et versions de modèles
- Anthropic, fonctionnement des appels d'outils
- Google, modèles Gemini et règles de version
- Mistral AI, catalogue des modèles
- NIST, AI Risk Management Framework